
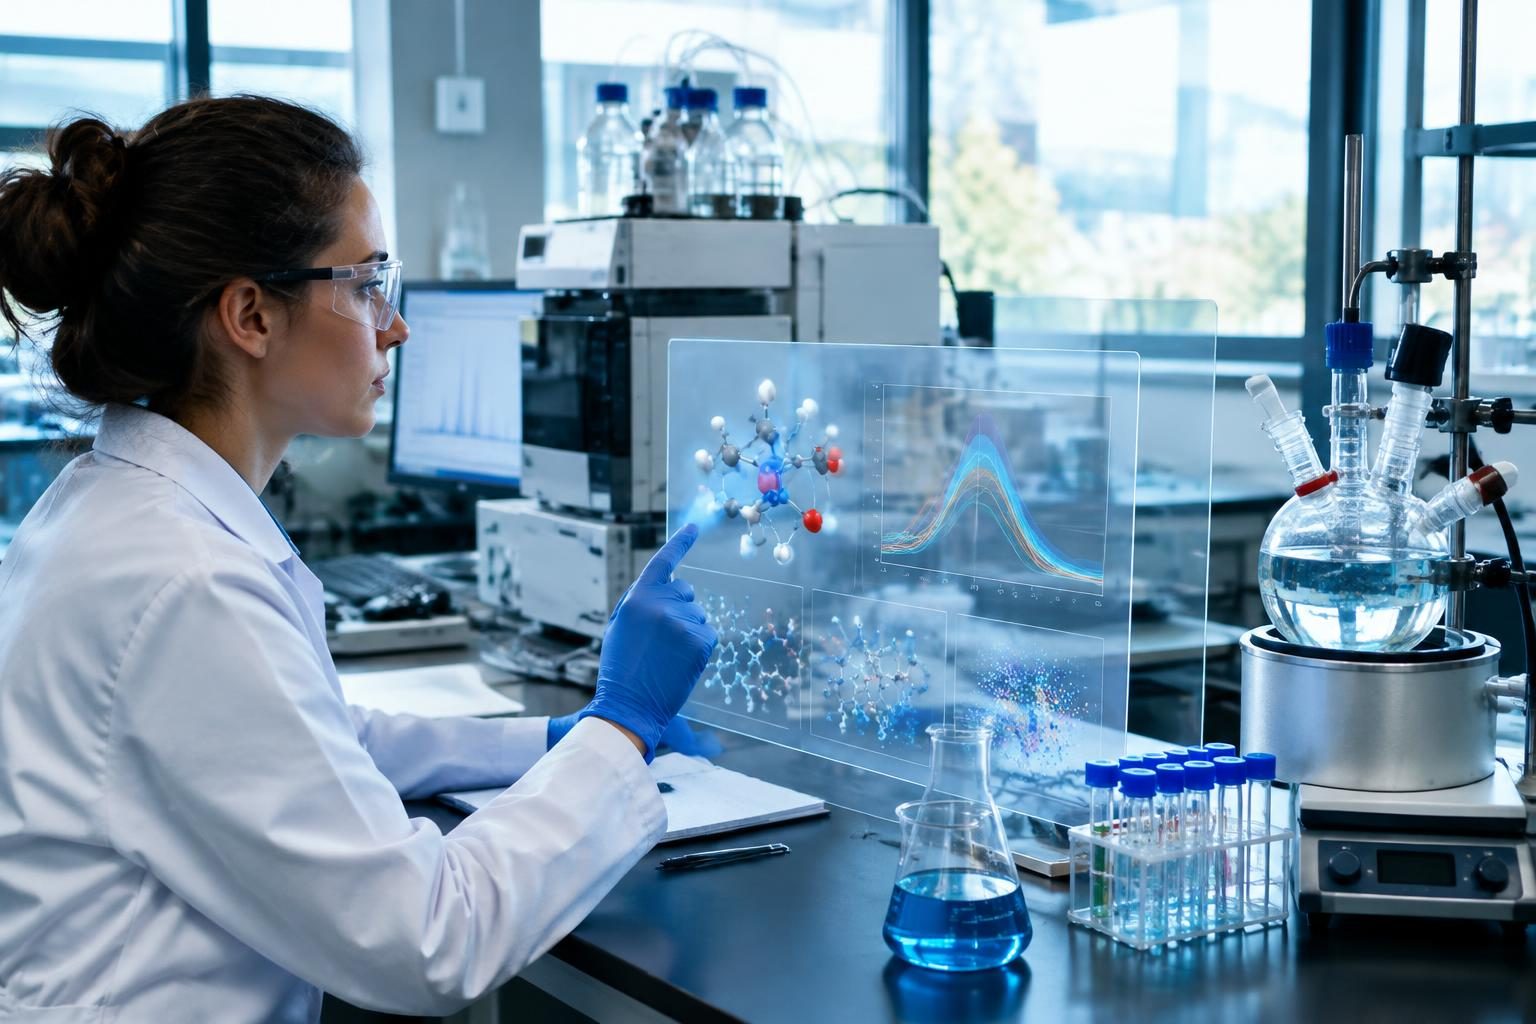
La inteligencia artificial puede reducir el tiempo necesario para buscar moléculas, materiales y reacciones prometedoras, pero no reemplaza la verificación experimental. Este es el punto central de un análisis reciente publicado sobre Chemical Society, creado por investigadores de Skoltech, el Instituto Zelinsky de Química Orgánica, la Universidad de ITMO y otras instituciones.
El valor concreto de la IA en el laboratorio
En investigación química, AI no es una sola herramienta. Incluye modelos estadísticos, redes neuronales, sistemas de aprendizaje automático y modelos generativos capaces de proponer estructuras moleculares o condiciones de reacción. Su principal ventaja es la velocidad con la que pueden examinar grandes cantidades de datos.
Un investigador puede utilizar estos sistemas para predecir propiedades de una molécula, estimar el rendimiento de una reacción, identificar materiales con ciertas características o reducir el número de experimentos a realizar. En áreas como catalisis, energía y descubrimiento de drogas, esta selección preliminar puede tener un valor práctico importante.
AI también es útil en el análisis de imágenes, espectros y resultados de herramientas automáticas. En algunos casos reconoce correlaciones difíciles de identificar con el ojo, especialmente cuando los datos son numerosos y recogidos con protocolos uniformes.
¿Por qué un pronóstico no es una prueba
El límite emerge cuando se evalúa el modelo sobre datos demasiado similares a los utilizados durante el entrenamiento. Un alto rendimiento en una prueba de computadora puede reflejar la capacidad de reconocer patrones ya presentes en la muestra, sin mostrar que el sistema puede trabajar en moléculas, herramientas o condiciones completamente nuevas.
En la química, la transición del cálculo al banco de laboratorio es particularmente delicada. El rendimiento de una reacción depende a menudo de factores que no aparecen en la base de datos: pureza de reactivos, humedad, forma del vaso, velocidad de adición, agitación, temperatura real y capacidad del operador.
Incluso una pequeña variación puede cambiar el resultado. Un modelo puede sugerir una combinación plausible de reactivos, pero no saben si una sustancia es inestable en el aire, si un subproducto dificulta la purificación o si una reacción requiere un pasaje indocumentado preliminar.
Los datos determinan la calidad del resultado
Los modelos aprenden de los datos disponibles. Si los datos son incompletos, desequilibrados o obtenidos por diferentes métodos, las previsiones también pueden ser frágiles. En las bases de datos químicas, las reacciones exitosas y publicadas suelen estar excesivamente representadas, mientras que los experimentos fallidos siguen siendo menos visibles.
Esta selección crea un problema: el sistema puede aprender que ciertas condiciones están asociadas con el éxito sin entender con qué frecuencia producen resultados negativos. Además, dos laboratorios pueden describir el mismo procedimiento con diferentes niveles de detalle, lo que dificulta la comparación de experimentos.
Por eso no es suficiente indicar la precisión promedio de un algoritmo. Es necesario saber qué moléculas han sido probadas, cuán lejos está el nuevo caso de los datos de entrenamiento, qué errores produce y con qué incertidumbre formula las previsiones.



Lascia un commento